RAGのリランカー(Reranker)比較【2026】Cohere・Voyage・Jina・BGEを独自集計
一次ソース検証型AIメディア編集部 ・ 監修: 依田 尚人
目次
- リランカーとは?RAGで検索精度が上がる仕組み【定義と早見表】
- リランカーの定義と、埋め込み検索(bi-encoder)との役割分担
- リランカーで検索精度はどれだけ上がるのか(公開検証の数値)
- いつリランカーが必要で、いつ不要か
- 主要リランカー横断比較【2026・独自集計】
- 一覧比較表(独自集計)|提供形態・多言語・コンテキスト長・課金・ライセンス
- 料金は直接比較できない|per-search・per-token・自前GPUの違い
- 最大コンテキスト長・最大文書数の違いと実務インパクト
- プロバイダ別の特徴と制約(弱点も同粒度)
- Cohere Rerank 4(Pro/Fast)と旧v3.5
- Voyage rerank-2.5 / lite(MongoDB傘下)
- Jina Reranker v3 / v2(ライセンスに注意)
- BGE reranker(OSS)v2-m3 / gemma系|自前運用のコスト構造
- 日本語RAGでのリランカー選び【独自の切り口】
- クローズドAPIの多言語 vs 日本語特化OSS(ruri・japanese-reranker・JaColBERT)
- Zerank-2など新興モデルと鮮度の注意点
- 用途別の選び方と導入前の検証
- 精度重視/レイテンシ重視/コスト重視/データ保持の4軸で選ぶ
- 導入前に自社データで測る(評価の考え方)
- まとめ
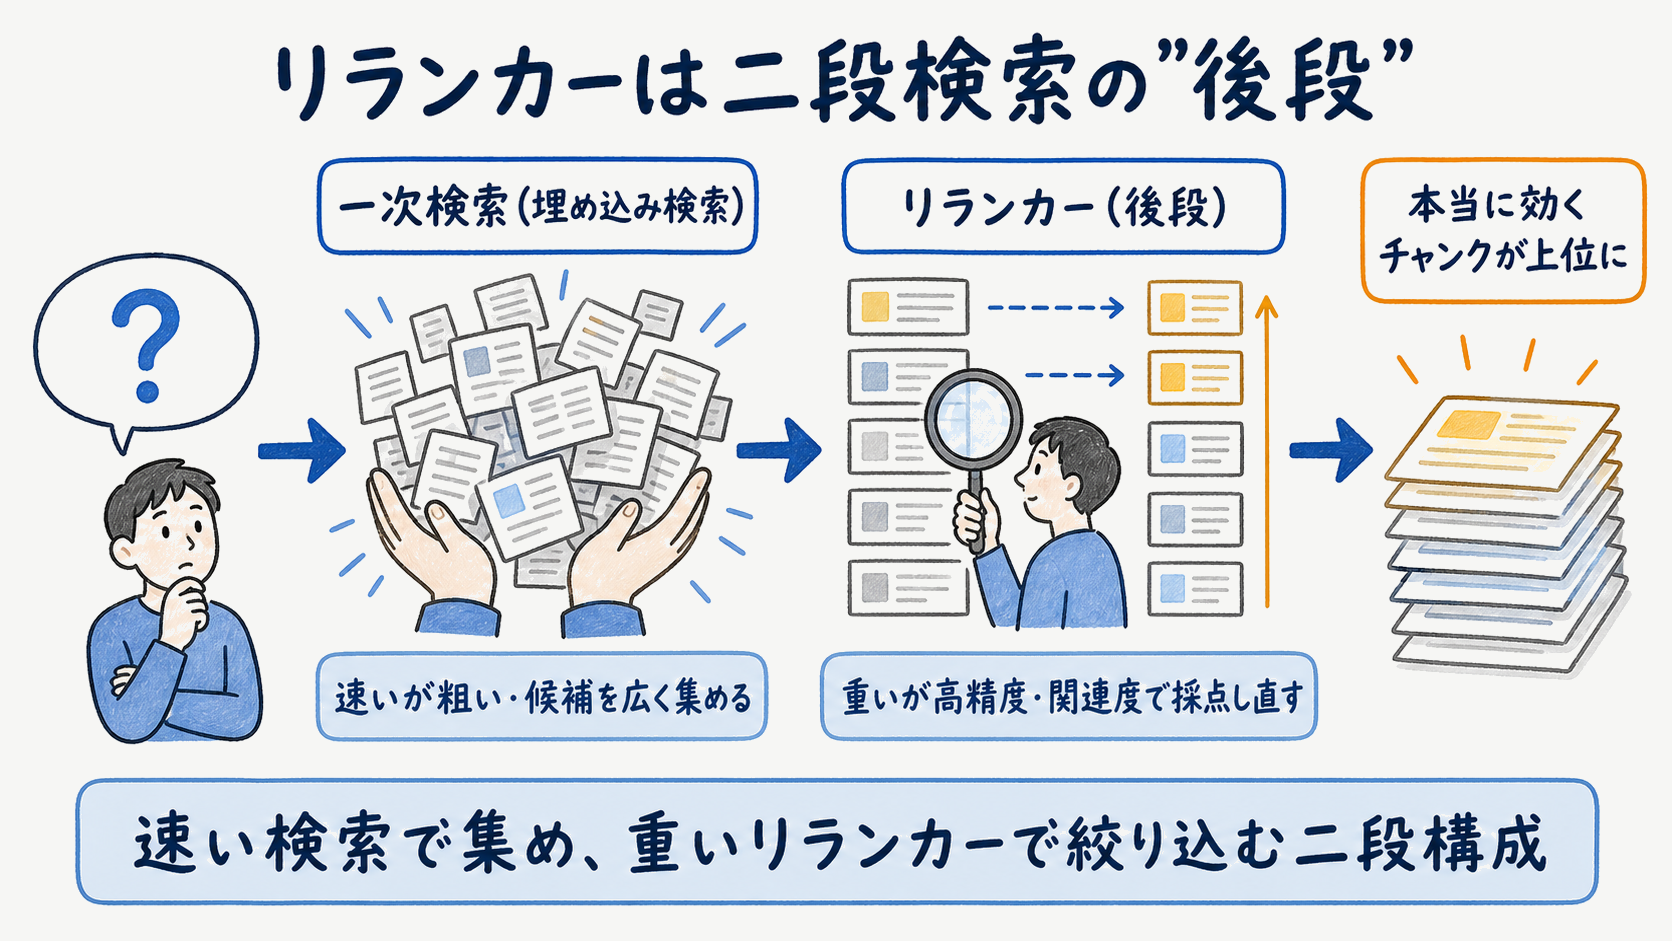
リランカー(Reranker)とは、RAGの一次検索で集めた候補文書を「質問との関連度」で採点し直し、本当に効くチャンクを上位へ並べ替える後段の仕組みです。結論から言うと、2026年時点で「どんな用途にも最適な1本」は存在せず、精度・レイテンシ・料金体系・データ保持要件・日本語対応のどれを優先するかで最適解が変わります。
主力はマネージドAPIのCohere Rerank 4(Pro/Fast)、Voyage rerank-2.5(MongoDB傘下)、Jina Reranker v3、そしてOSSのBGE rerankerや日本語特化のruri・JaColBERTなどです。料金はper-searchとper-tokenと自前GPUで構造が異なり、単純には比較できません。本記事は各社公式pricingとdocs、Anthropicの公開検証、中立ベンチ(agentset/JaCWIR)を横断集計し、提供形態・多言語対応・コンテキスト長・課金体系・ライセンスを1表に整理します。
本記事は特定の製品を勝たせる目的では書いていません。各モデルの強みと制約(クローズドでのデータ外部送信、per-search課金の膨張、OSSの運用負荷、Jina v3の非商用ライセンス等)を同じ粒度で並べ、当社サービスや特定ツールへの送客はしません。ベンダー自社ベンチと中立ベンチは区別して扱い、料金・版数・順位は数ヶ月で変わるため、選定するその時点で公式pricingと最新リーダーボードを再確認してください。
リランカーはRAGの後段で候補を関連度に基づいて採点し直す仕組みです。2026年の主力はCohere Rerank 4・Voyage rerank-2.5・Jina Reranker v3・OSSのBGE/日本語特化モデルで、「万能の1本」はなく、精度・レイテンシ・料金体系・データ保持・日本語対応の優先順位で最適解が変わります。Anthropicの公開検証では取得失敗率が5.7%から1.9%へ(約67%減)改善しました(出典: Anthropic・参照2026-07-18)。
リランカーとは?RAGで検索精度が上がる仕組み【定義と早見表】
リランカーの定義と、埋め込み検索(bi-encoder)との役割分担
リランカーとは、一次検索で得た候補文書をクエリとの関連度で採点し直して並べ替える後段モデルです。多くはcross-encoder系で、埋め込み検索(bi-encoder)やBM25による一次検索の「後ろ」に置く二段構成で使います。RAG全体の流れはRAGの基本構成を前提とすると理解しやすくなります。
| 方式 | 入力の扱い | 速度 | 精度 | RAGでの役割 |
|---|---|---|---|---|
| bi-encoder(埋め込み) | クエリと文書を別々にベクトル化 | 速い | 粗い | 一次検索(候補集め) |
| cross-encoder(リランカー) | クエリと文書を同時に読む | 重い | 高い | 後段(候補の並べ替え) |
リランカーで検索精度はどれだけ上がるのか(公開検証の数値)
Anthropicの公開検証では、上位20チャンクの取得失敗率がreranking追加で5.7%から1.9%へ(約67%減)改善したと報告されています(出典: Anthropic「Contextual Retrieval」・参照2026-07-18)。日本語RAGでも精度改善の報告は多いものの、効果は一次検索の質と対象データに強く依存します。他社の数値をそのまま自社成績に読み替えず、必ず自社データで確認するのが前提です。
いつリランカーが必要で、いつ不要か
必要になりやすいのは、候補にノイズが多い、上位K件の精度が事業KPIに直結する、多言語や表記ゆれが混在する、といったケースです。逆に、検索対象が小さい、一次検索で既に精度が十分、ミリ秒を争うレイテンシ要件、といった場合は過剰になりがちです。反復検索のなかで関連度を制御する構成はエージェント型RAGでも重要になります。中立に見れば「必ず入れるべき」ものではなく、要件しだいの選択肢です。
主要リランカー横断比較【2026・独自集計】
一覧比較表(独自集計)|提供形態・多言語・コンテキスト長・課金・ライセンス
以下は主要リランカーを6軸で横断集計した独自比較表です。検索基盤そのものの選定はベクトルデータベース比較と合わせて検討してください。
| モデル | 提供形態 | 日本語 | 最大コンテキスト/文書数 | 課金体系 | レイテンシ | ライセンス |
|---|---|---|---|---|---|---|
| Cohere Rerank 4 Pro | API | 対応 | 500トークン超は自動分割 | per-search | 中 | 商用可(クローズド) |
| Cohere Rerank 4 Fast | API | 対応 | 同上 | per-search | 低 | 商用可(クローズド) |
| Cohere Rerank v3.5 | API | 対応 | 同上 | per-search | 低〜中 | 商用可(クローズド) |
| Voyage rerank-2.5 | API | 対応 | 32Kトークン | per-token | 中 | 商用可(クローズド) |
| Voyage rerank-2.5-lite | API | 対応 | 32Kトークン | per-token | 低 | 商用可(クローズド) |
| Jina Reranker v3 | API/OSS重み | 対応 | 131K/最大64文書 | per-token(API) | 中 | CC-BY-NC 4.0(商用は別契約) |
| Jina Reranker v2 base | API/OSS | 対応(100言語超) | 長文対応 | per-token(API) | 低 | CC-BY-NC 4.0(商用は別契約) |
| BGE bge-reranker-v2-m3 | OSS | 対応(多言語) | 自環境で設定 | 自前GPU | 環境依存 | 商用可(OSS) |
| BGE v2-gemma | OSS | 部分対応 | 自環境で設定 | 自前GPU | 環境依存 | 商用可(OSS) |
| BGE v2.5-gemma2-lightweight | OSS | 部分対応 | 自環境で設定 | 自前GPU | 環境依存 | 商用可(OSS) |
| ruri-v3-reranker(日本語特化) | OSS | 特化 | 自環境で設定 | 自前GPU | 環境依存 | 商用可(OSS) |
| japanese-reranker-v2(tiny〜base) | OSS | 特化 | 自環境で設定 | 自前GPU | 低(軽量) | 商用可(OSS) |
数値・条件は変動するため、選定時に各社公式pricing/docsで再確認してください(出典: 各社公式pricing/docs・参照2026-07-18)。
料金は直接比較できない|per-search・per-token・自前GPUの違い
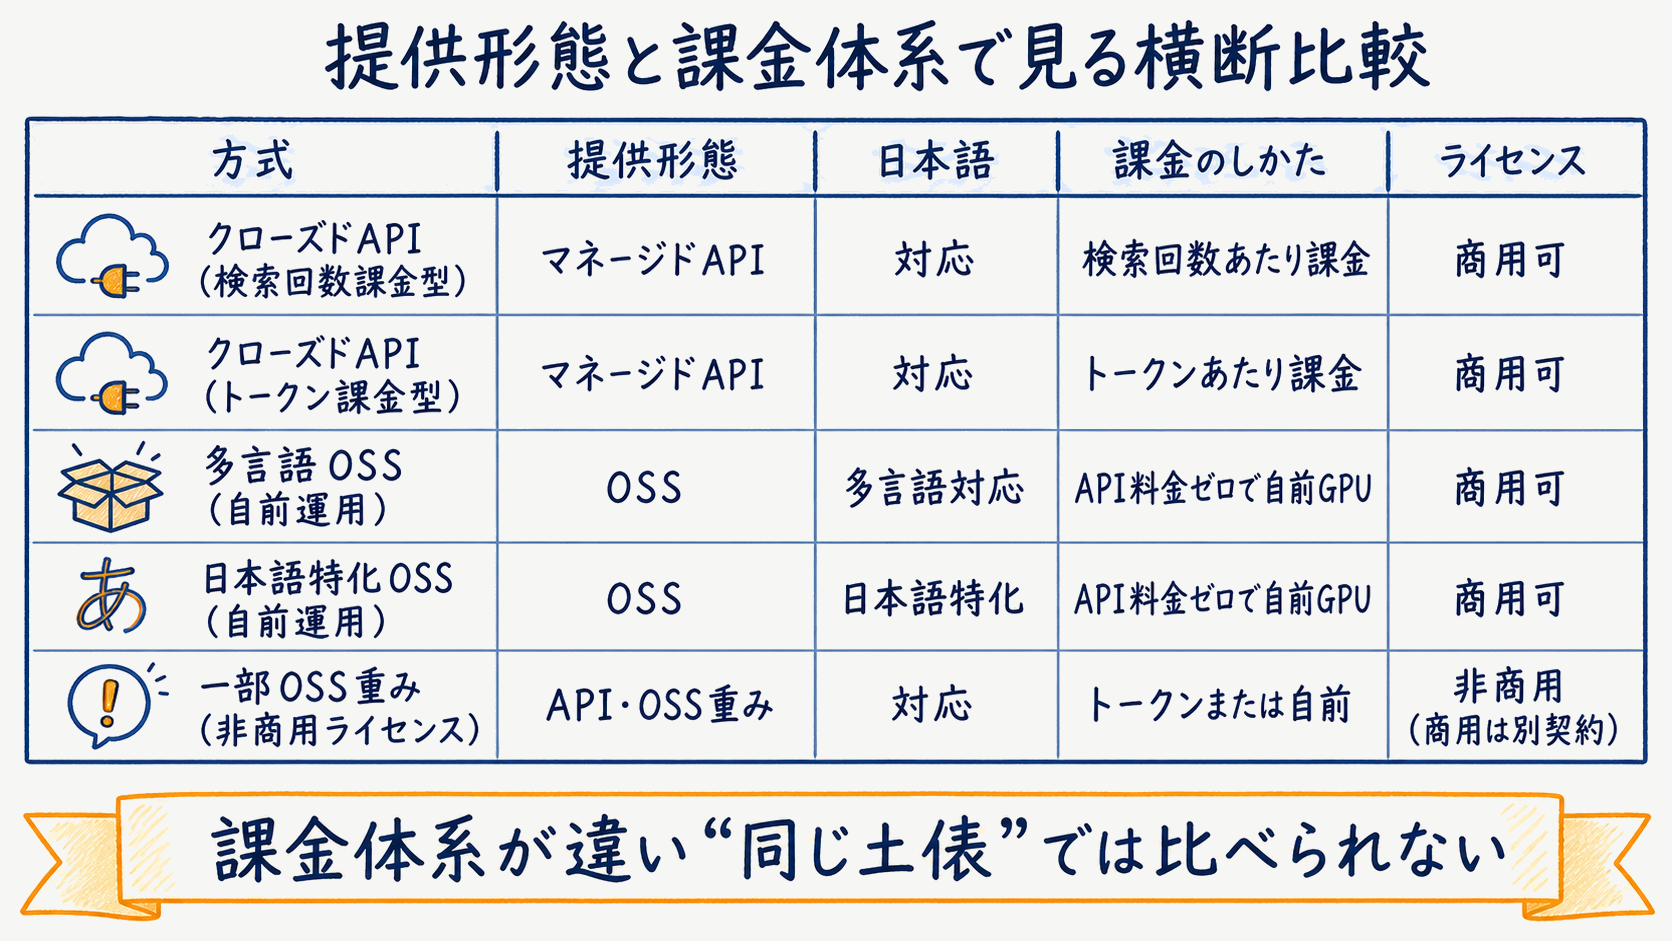
課金体系が構造的に異なるため、$/searchと$/1Mトークンは同じ土俵で比べられません。Cohereはper-search(Rerank 4 Pro 約$0.0025、Fast 約$0.002、旧v3.5 約$0.001/search)、VoyageとJinaはper-token(Voyage rerank-2.5 約$0.05、lite 約$0.02/1Mトークン、無料枠あり)、BGEや日本語OSSはAPI料金ゼロで自前GPUコストが載ります(出典: Cohere/Voyage公式pricing・参照2026-07-18)。
| 課金モデル | 該当 | 課金単位 | 試算に必要な変数 |
|---|---|---|---|
| per-search | Cohere | 1search=クエリ+最大100文書 | 想定クエリ数 |
| per-token | Voyage・Jina | 入力トークン | 平均文書長×文書数 |
| 自前GPU | BGE・日本語OSS | API料金ゼロ | GPU時間・運用工数 |
実コストは想定クエリ数と平均文書長で変わるため、代表的な業務ケースを1つ決めて試算しないと、$表示だけでは逆転が起こります。
最大コンテキスト長・最大文書数の違いと実務インパクト
最大コンテキスト長・最大文書数も選定を左右します。Jina Reranker v3は131Kトークン内で最大64文書を同時処理し、Voyage rerank-2.5は32Kトークンに対応します。Cohereは500トークンを超える文書を自動的に分割し、分割後のチャンク数だけ課金対象の文書数が増えます(出典: 各社docs・参照2026-07-18)。長いチャンクを丸ごと採点したいか細切れでよいかはRAGの分割設計と直結するため、チャンク分割戦略と一緒に決めるのが実務的です。
プロバイダ別の特徴と制約(弱点も同粒度)
Cohere Rerank 4(Pro/Fast)と旧v3.5
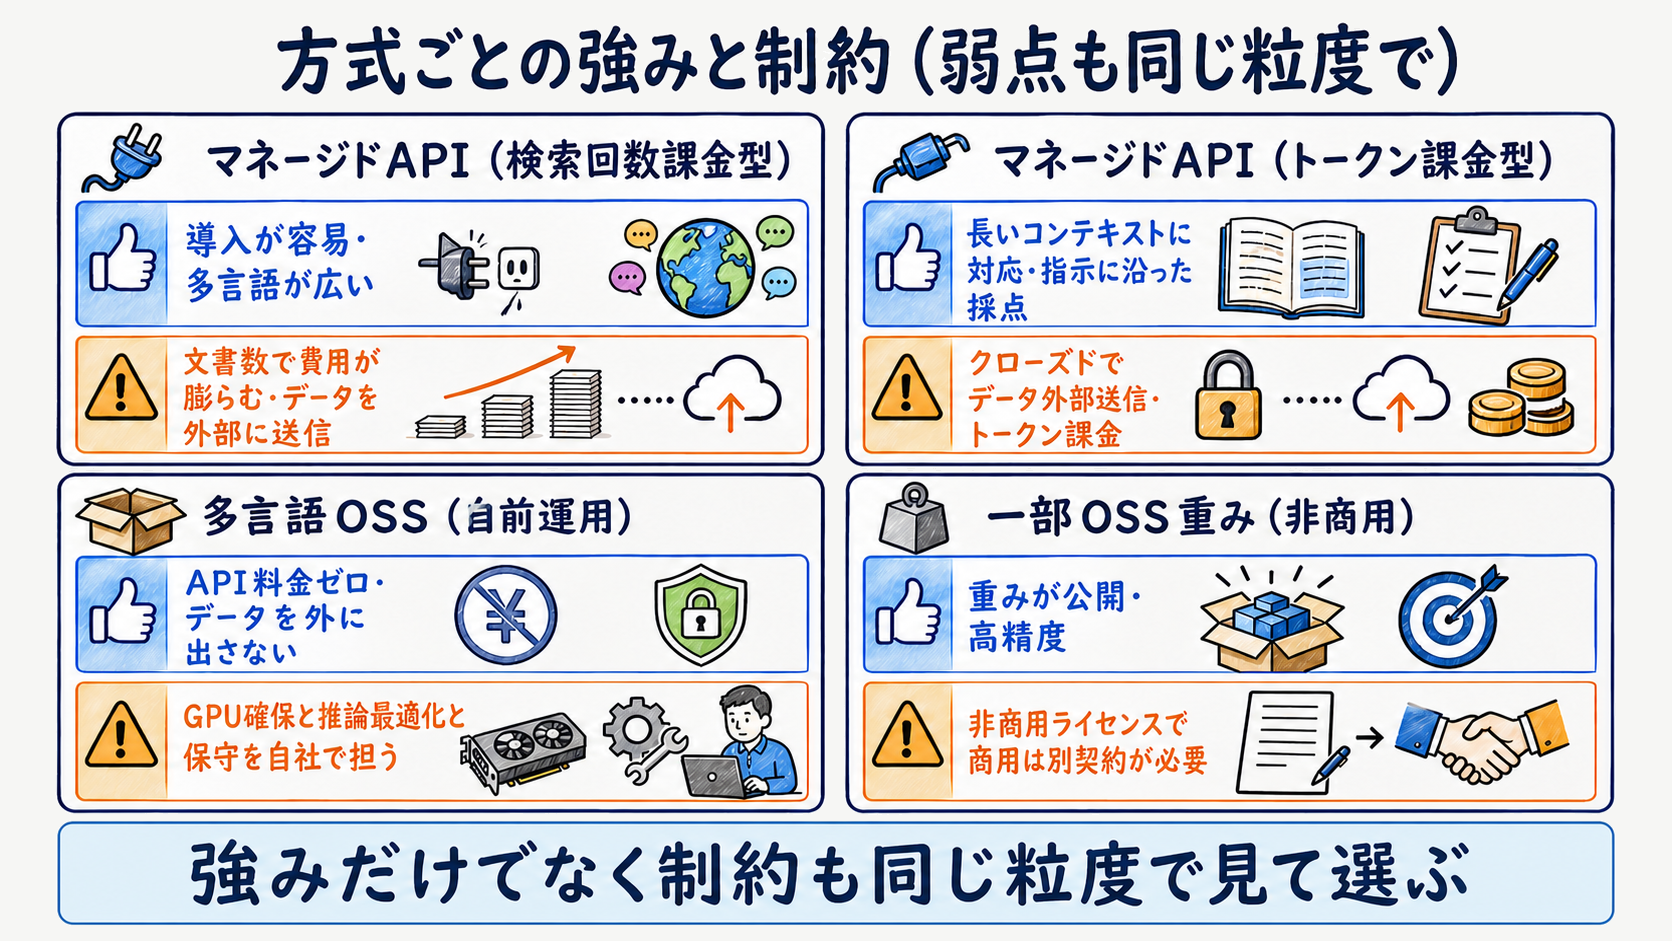
Cohere Rerank 4はPro(高精度・約$0.0025/search)とFast(低レイテンシ・約$0.002/search)の2系統で、旧v3.5(約$0.001/search)も残ります(出典: Cohere公式pricing・参照2026-07-18)。マネージドAPIで導入が容易で多言語対応も広い一方、per-search課金が文書数で膨らむ、クローズドでデータを外部送信する、自前運用ができない、といった制約があります。中立リーダーボードでも上位ですが、唯一解ではありません。
Voyage rerank-2.5 / lite(MongoDB傘下)
Voyage rerank-2.5(約$0.05/1Mトークン)とlite(約$0.02/1Mトークン)は、32Kコンテキストとinstruction-following、多言語に対応します(出典: Voyage/MongoDB公式・参照2026-07-18)。2025年にMongoDBが買収し「Voyage AI by MongoDB」として提供されており、統合方針や提供条件の変化に注意が必要です。自社ベンチで旧Cohere v3.5比の優位を公表していますが、これは「ベンダー公表値」であり、中立ベンチとは区別して読む必要があります。制約はクローズドとトークン課金です。
Jina Reranker v3 / v2(ライセンスに注意)
Jina Reranker v3は2025年10月公開の0.6Bモデルで、"last but not late interaction"によりBEIRでnDCG@10 61.94、最大64文書/131Kトークンを処理します(出典: Jina AI・参照2026-07-18)。v2 baseは100言語超に対応します。最も注意すべき制約は、v3の重みがCC-BY-NC 4.0(非商用)で、商用利用には別途ライセンス契約が必要な点です。OSS重みが公開されていても、商用可否は必ず確認してください。
BGE reranker(OSS)v2-m3 / gemma系|自前運用のコスト構造
BGE rerankerはOSSで、bge-reranker-v2-m3(軽量・多言語・デプロイ容易)、v2-gemma(英語+多言語)、v2.5-gemma2-lightweight(トークン圧縮で省リソース)などがあります(出典: BAAI/FlagEmbedding・参照2026-07-18)。API料金がゼロでデータを外に出さずコストを自前で管理できる反面、GPU確保・推論最適化・アップデート追従を自社で担う運用負荷が制約になります。
日本語RAGでのリランカー選び【独自の切り口】
クローズドAPIの多言語 vs 日本語特化OSS(ruri・japanese-reranker・JaColBERT)
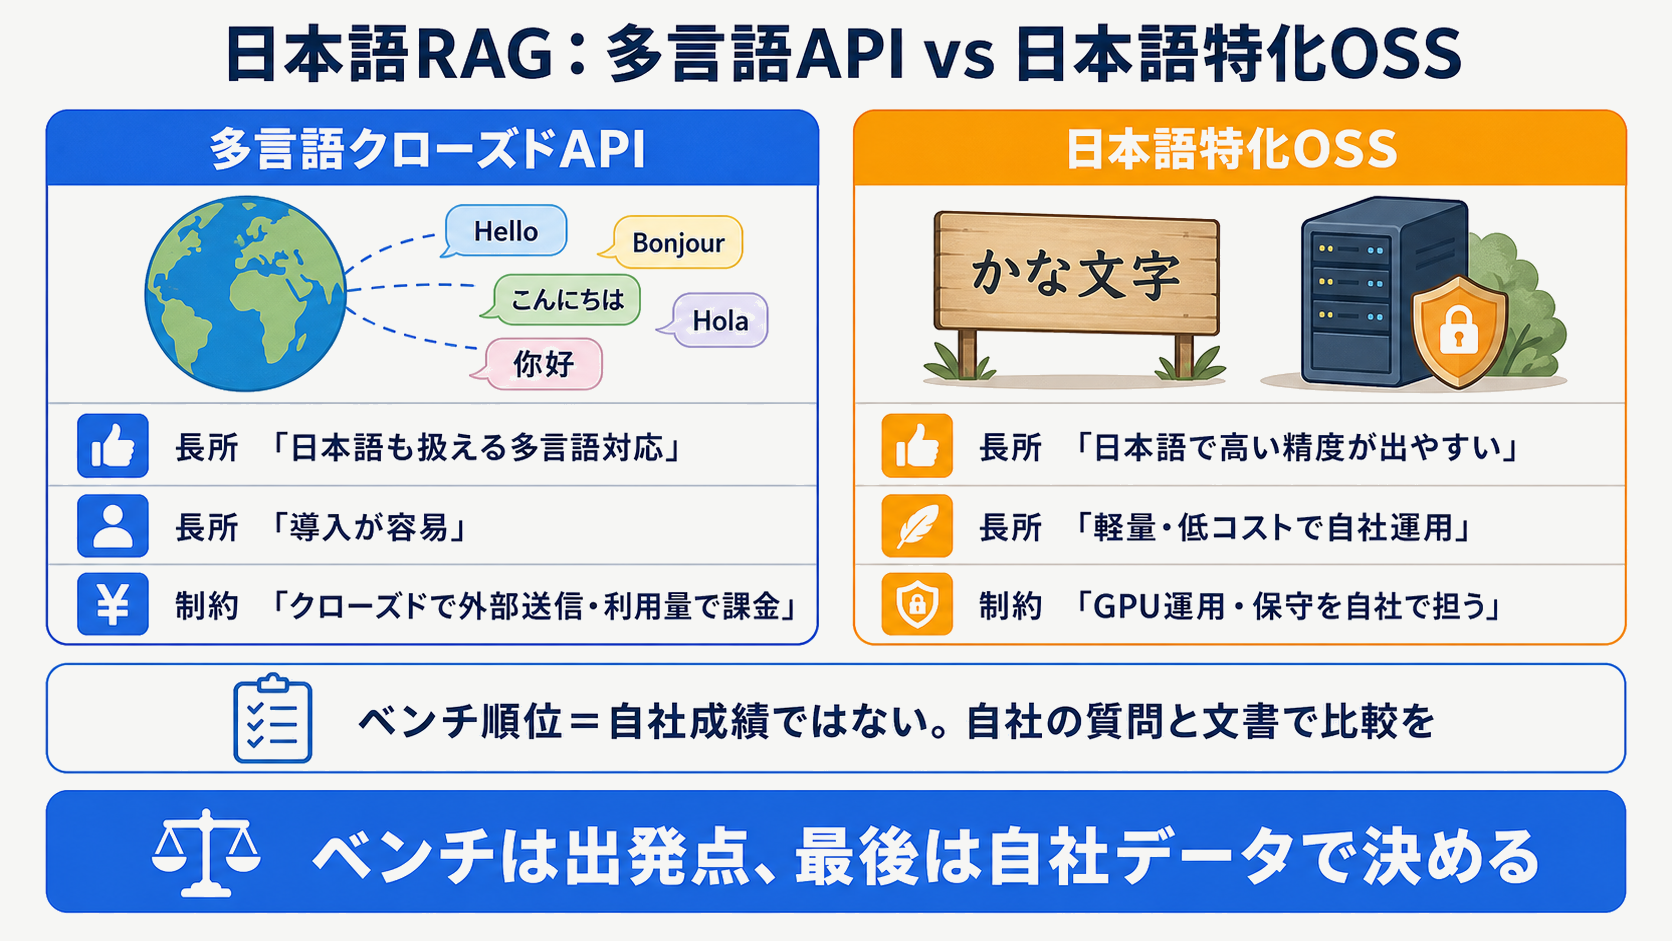
クローズドAPI(多言語で日本語も扱える)と日本語特化OSSには、それぞれ長所と制約があります。日本語検索の評価ベンチJaCWIRでは、日本語特化モデルが高いスコアを示します。
| モデル | MAP@10 | hit_rate@10 |
|---|---|---|
| ruri-reranker-large | 0.9463 | 0.99 |
| JaColBERT | 0.9035 | 0.9772 |
上表はJaCWIR公開ベンチの一例です(出典: JaCWIR・参照2026-07-18)。japanese-reranker-v2(tiny〜base)は軽量・低コストで自社運用に向きます。ただしベンチ条件と自社データは乖離するため、この順位をそのまま最終結論にしないでください。
Zerank-2など新興モデルと鮮度の注意点
中立リーダーボード(agentset)では、2026年時点でZerank-2が首位、Cohere Rerank 4 Proが僅差の2位という接戦になっています(出典: agentset・参照2026-07-18)。ここで強調したいのは、リランカーは版や順位が数ヶ月で入れ替わるという点です。個別の順位を鵜呑みにせず、選定するその時点で公式pricingと最新リーダーボードを再確認する運用にしてください。
用途別の選び方と導入前の検証
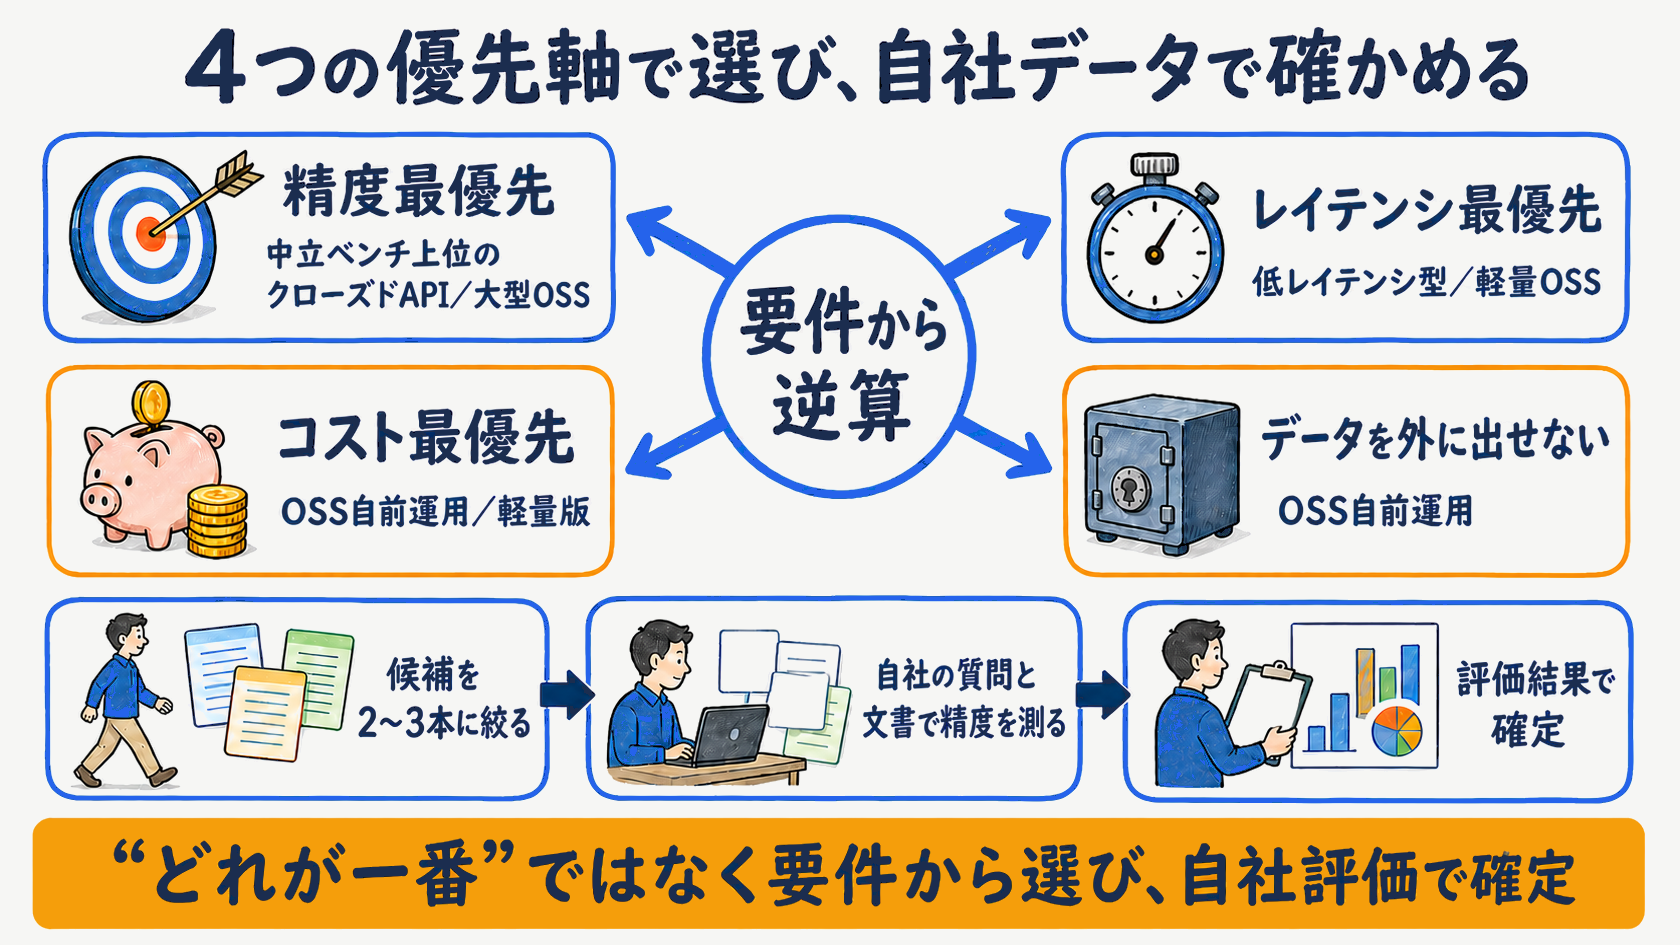
精度重視/レイテンシ重視/コスト重視/データ保持の4軸で選ぶ
「どれが一番」ではなく、要件から逆算します。精度・レイテンシ・コスト・データ保持の4軸で候補を絞るのが実務的です。
| 優先軸 | 向きやすい選択 |
|---|---|
| 精度最優先 | 中立ベンチ上位のクローズドAPI/大型OSS |
| レイテンシ最優先 | Fast系/軽量OSS |
| コスト最優先 | OSS自前運用/lite系 |
| データを外に出せない | OSS自前運用 |
複数の軸が競合する場合は、事業KPIに最も近い軸を最優先に据えて、候補を2〜3本まで絞り込みます。
導入前に自社データで測る(評価の考え方)
どのモデルも、公開ベンチの順位=自社成績ではありません。自社の実際の質問と文書でnDCGやRecall、取得失敗率を測ってから確定するのが、遠回りに見えて最短です。評価指標の選び方と測り方はRAGの評価方法にまとめています。比較表はあくまで出発点で、最後は自社評価で決めるのが確実です。
まとめ
リランカーはRAGの検索精度を底上げする有力な後段ですが、「万能の1本」はありません。2026年はCohere Rerank 4・Voyage rerank-2.5・Jina Reranker v3・OSSのBGE・日本語特化モデルが主力で、料金体系(per-search/per-token/自前GPU)とライセンス、日本語対応が選定の分かれ目です。中立ベンチは参考にしつつ、順位は数ヶ月で変わる前提に立ち、最後は自社データでの評価に落とし込んでください。
関連記事として、RAGそのものの仕組みはRAGの基本構成、検索基盤の選び方はベクトルデータベース比較、導入後の精度検証はRAGの評価方法、後段と密接に関わるチャンク設計はチャンク分割戦略で詳しく整理しています。
よくある質問
- Q. リランカーを使うとRAGの検索精度はどれくらい上がりますか?
- Anthropicの公開検証では、上位20チャンクの取得失敗率がreranking追加で5.7%から1.9%へ(約67%減)改善しています(出典: Anthropic「Contextual Retrieval」・参照2026-07-18)。日本語RAGでも精度改善の報告は多いものの、効果は一次検索の質と自社データに依存します。他社の数値をそのまま当てはめず、自社評価で確認することが前提です。
- Q. Cohere・Voyage・Jinaの料金はどれが安いですか?
- 課金体系が構造的に異なり単純比較はできません。Cohereはper-search(1リクエスト=クエリ+最大100文書)、VoyageとJinaはper-token(入力トークン課金)、BGEなどOSSはAPI料金ゼロで自前GPUコストが発生します(出典: 各社公式pricing・参照2026-07-18)。想定クエリ数と平均文書長を入れて自社ケースで試算するのが正確です。
- Q. 無料またはOSSのリランカーはありますか?
- あります。BGE(bge-reranker-v2-m3ほか)や日本語特化のruri-v3-reranker・japanese-reranker-v2・JaColBERTがOSSとして公開されています。API料金は不要ですがGPU運用・保守コストが発生します。またJina Reranker v3の重みはCC-BY-NC 4.0(非商用)で、商用利用は別ライセンス契約が必要な点に注意してください(出典: Jina AI・参照2026-07-18)。
- Q. 日本語RAGにはどのリランカーが向いていますか?
- クローズドAPI(多言語対応)と日本語特化OSSにそれぞれ長所と制約があり、一概に最適は決まりません。日本語ベンチのJaCWIRではruri系やJaColBERTが高いスコアを示しますが、ベンチ条件と自社データは異なります(出典: JaCWIR・参照2026-07-18)。自社の質問・文書に近い条件で複数候補を比較して選ぶのが確実です。
- Q. リランカーは必ず導入すべきですか?
- 必須ではありません。検索対象が小さい場合や一次検索で既に精度が十分な場合、またミリ秒単位のレイテンシを争う用途では過剰になることがあります。候補にノイズが多く、上位K件の精度が成果に直結するケースで効果が出やすい仕組みです。
- Q. cross-encoderとbi-encoderの違いは何ですか?
- bi-encoderはクエリと文書を別々にベクトル化して高速に検索する方式、cross-encoderはクエリと文書を同時に読み込んで関連度を高精度に採点する方式です。リランカーの多くはcross-encoder系で、bi-encoderやBM25による一次検索の後段に置く二段構成で使われます。
出典・参考資料
- 1.
- 2.
- 3.
- 4.
- 5.
- 6.
- 7.
- 8.
- 9.
- 10.
- 11.
- 12.