ハイブリッド検索RAGとは【2026】BM25×ベクトル検索とRRF融合を中立解説
一次ソース検証型AIメディア編集部 ・ 監修: 依田 尚人
目次
- ハイブリッド検索RAGとは(3分でわかる定義)
- キーワード検索(BM25)とベクトル検索の違い
- なぜ両方を組み合わせると検索精度が上がるのか(相補性)
- 検索方式3種を同粒度で比較(独自比較表)
- キーワード・ベクトル・ハイブリッドの3方式×5評価軸
- 質問タイプ別にどの検索方式が向くか
- スコアをどう融合するか(RRF・加重和・正規化)
- RRF(Reciprocal Rank Fusion)の仕組みと定数k
- 融合方式3種の比較と選び方(RRF/加重和/スコア正規化)
- 自社にハイブリッド検索は必要か(判定チェックリスト)
- 純ベクトル検索で足りるケース
- ハイブリッドが必要になる兆候チェックリスト
- 導入の代償と見送ってよいケース(中立フレーム)
- 2インデックス運用・レイテンシ増・kチューニングの負担
- ハイブリッド検索を見送ってよい条件
- RAG検索品質改善レイヤー地図(独自図・関連記事マップ)
- チャンク分割→ハイブリッド融合→リランカーの位置づけと各レイヤーの深掘り
- まとめ
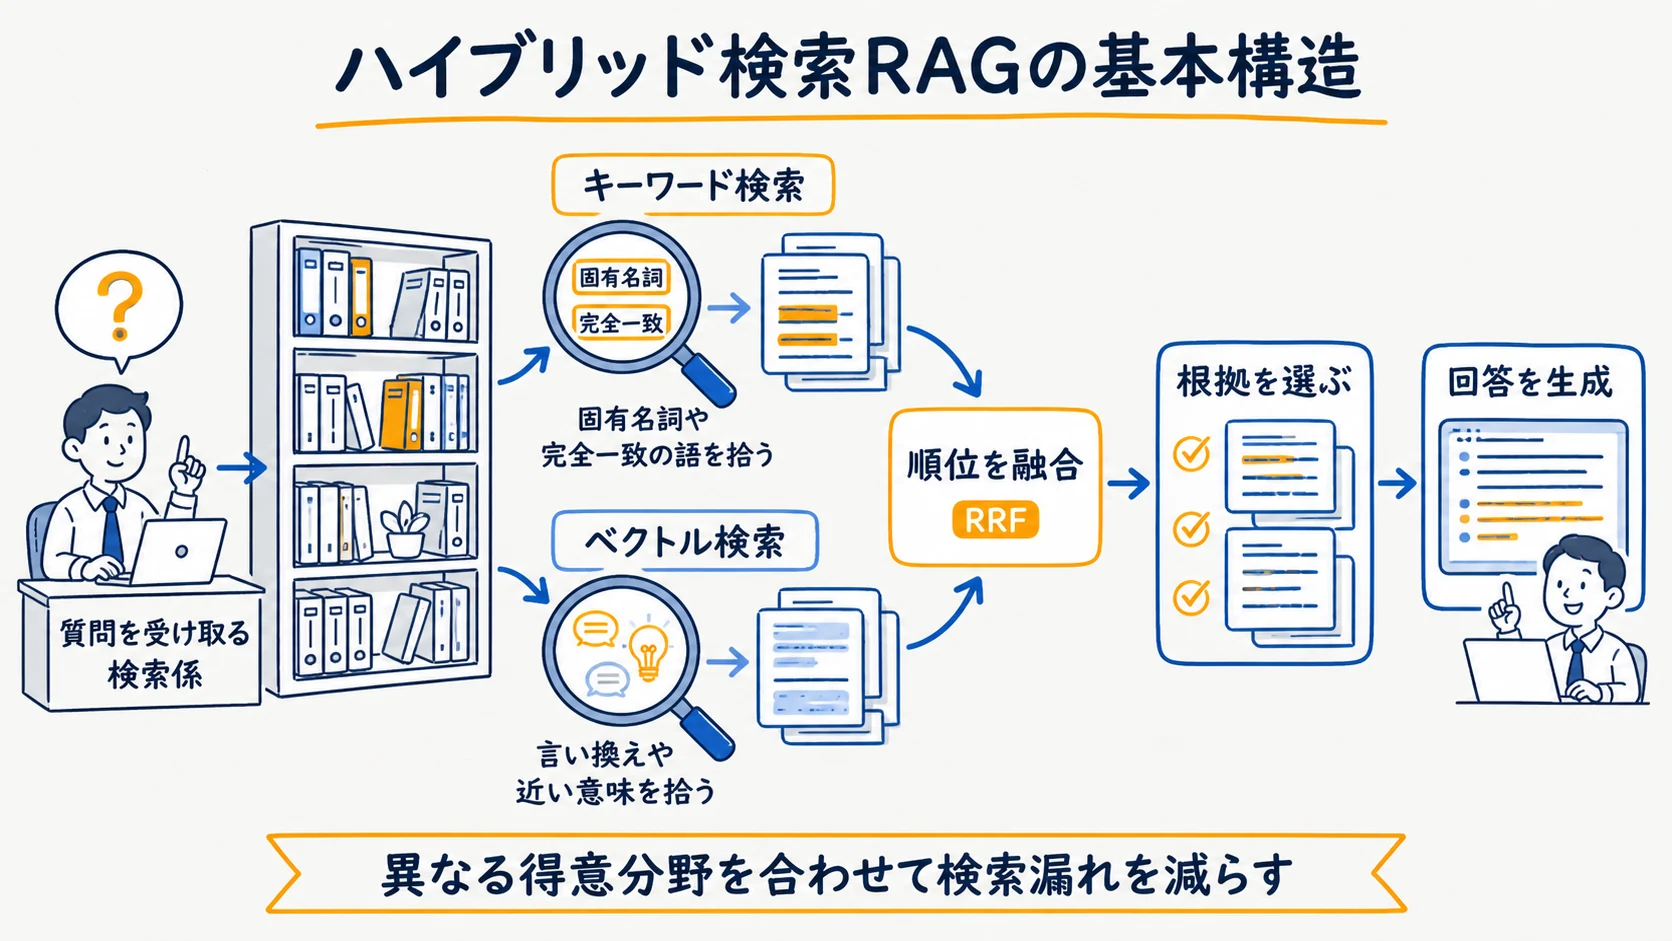
ハイブリッド検索RAGとは、キーワード検索(BM25)とベクトル検索を同時に実行し、両者の結果をRRF(Reciprocal Rank Fusion)などで融合して検索精度を高めるRAGの検索手法です。固有名詞・型番の完全一致に強いキーワード検索と、言い換え・意味の近さに強いベクトル検索の弱点を相互に補い合うのが要点で、社内固有名詞やエラーコードが多い文書ほど効果が出やすくなります。ただし2インデックス運用・レイテンシ増・kのチューニングという代償があり、純ベクトル検索で足りるケースもあります。
導入判断では「ハイブリッドの方が高性能」と決めつけず、現行検索がどの質問で何を取りこぼしたかを先に分類します。完全一致の失敗と意味検索の失敗が同じ業務で起きているときに候補へ入れ、評価用の質問と正解文書を固定して単一方式と比べます。
本記事は特定の検索製品やデータ基盤と利害関係を持たず、方式・機能数・速度によるランキングを作りません。キーワード、ベクトル、ハイブリッドの強みと弱み、RRF、加重和、スコア正規化の調整負担を同じ粒度で整理し、自社サービスへの送客は行いません。比較表、判定チェックリスト、検索品質改善レイヤー地図はai-feed編集部作成の概念整理であり、実測性能値ではありません。
要点サマリ(2026年8月時点・ai-feed編集部作成)
- BM25は単語一致、ベクトル検索は意味の近さを主な手掛かりにする。
- ハイブリッド検索は両方式の候補を集め、順位またはスコアを融合する。
- RRFは元スコアの尺度をそろえず、順位から統合値を作れる。
- 固有名詞の失敗と意味検索の失敗が併存すると導入候補になる。
- 品質差が小さければ、単一方式の簡潔さを優先してよい。
ハイブリッド検索RAGとは(3分でわかる定義)
キーワード検索(BM25)とベクトル検索の違い
BM25は、質問と文書に現れる語の一致を手掛かりに、語の出現頻度、文書集合での珍しさ、文書長を考慮して順位を付ける方式です。製品型番、規程名、部署コード、エラーコードのように、文字列そのものへ意味がある質問を拾いやすい一方、「解約」と「契約をやめる」のような言い換えは一致しないことがあります。
ベクトル検索は、質問と文書を埋め込み表現へ変換し、意味的な近さから候補を探します。表現が違っても主題が近い文書を拾える反面、似た説明が多い文書群では固有名詞の差を弱く扱う場合があります。保存先や検索基盤を選ぶ前提はベクトルデータベース比較で整理しています。
なぜ両方を組み合わせると検索精度が上がるのか(相補性)
ハイブリッド検索は、同じ質問をBM25とベクトル検索へ渡し、それぞれの上位候補を統合します。一方が見落とした文書を他方が候補へ戻せるため、正解文書が後段へ届く可能性を高められます。ただし、候補が増えるだけで回答の正しさが保証されるわけではありません。
効果が出るのは、質問集合の中に完全一致型と言い換え型が混在し、両方式の失敗が異なるときです。両方が同じ誤文書を拾う場合や、正解が文書庫にない場合は融合しても改善しません。RAGの仕組みと導入条件に沿い、文書の収録、検索、生成を分けて原因を調べます。
検索方式3種を同粒度で比較(独自比較表)
キーワード・ベクトル・ハイブリッドの3方式×5評価軸
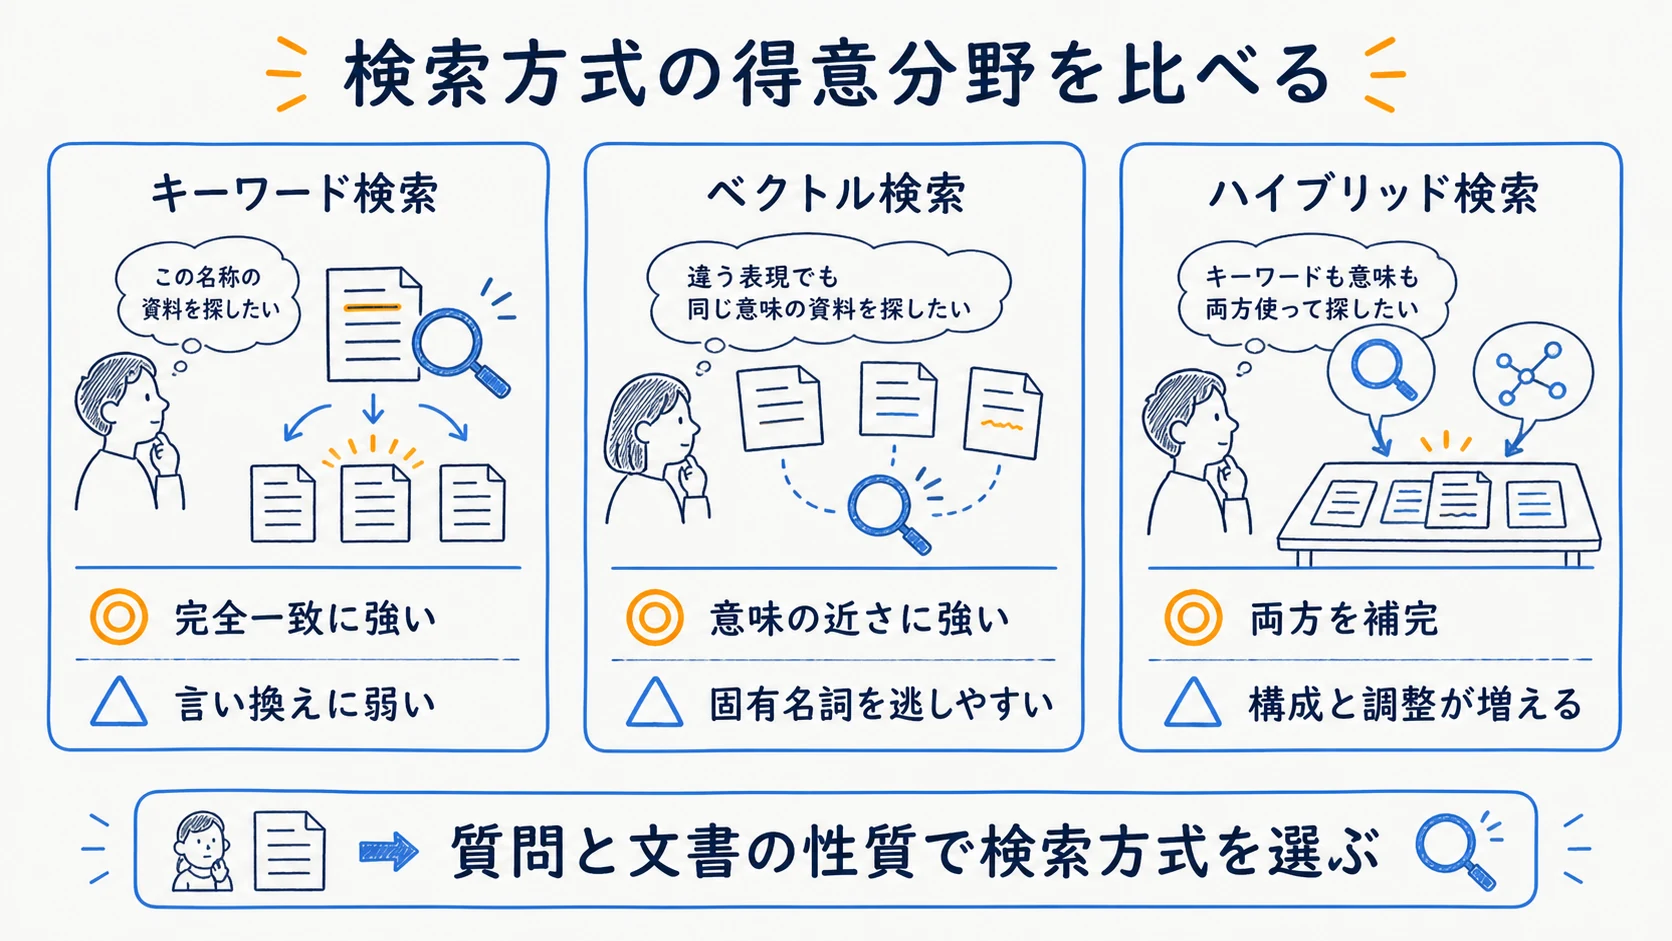
次表は3方式を、固有名詞、言い換え、実装難度、必要インフラ、向く質問という5軸でそろえた独自比較です。「強い」は常に優れるという意味ではなく、その手掛かりが質問と文書に存在する場合の適合度を示します(出所: ai-feed編集部作成)。
| 方式 | 固有名詞・型番の一致 | 言い換え・意味的類似 | 実装難度 | 必要インフラ | 向く質問タイプ |
|---|---|---|---|---|---|
| キーワード検索(BM25) | 強い | 表記差に弱い | 比較的低い | 全文検索インデックス | 名称・番号を含む照会 |
| ベクトル検索 | 固有語を逃す場合あり | 強い | 中程度 | 埋め込み生成・ベクトル索引 | 自然文・概念の照会 |
| ハイブリッド検索 | 両方式で補完 | 両方式で補完 | 高い | 2索引・融合処理 | 名称と自然文が混在する照会 |
実装難度は製品の機能数ではなく、文書更新、索引同期、検索、融合、監視まで自社が担う範囲で変わります。ハイブリッドが両列で「補完」でも、単一方式の失敗が少なければ追加構成の利益は小さくなります。比較の目的は勝者選びではなく、現在の検索失敗と必要構成を対応させることです。
質問タイプ別にどの検索方式が向くか
「AB-1200の復旧手順」のように識別子が明確なら、BM25を起点にします。「退職時に必要な社内手続き」のように文書と質問の表現がずれるなら、ベクトル検索が候補です。「AB-1200が停止したとき安全に戻す方法」のように識別子と自然文が混ざるなら、ハイブリッドを比較対象にします。例は方式選択を説明する架空の質問であり、性能実測ではありません。
短い質問か長い質問かだけでは決めません。評価セットを識別子型、言い換え型、混合型、曖昧型へ分け、正解文書が上位候補へ入るかを方式別に記録します。生成回答の文章品質と混ぜず、まず検索段階の再現率と不要候補を確認します。
スコアをどう融合するか(RRF・加重和・正規化)
RRF(Reciprocal Rank Fusion)の仕組みと定数k
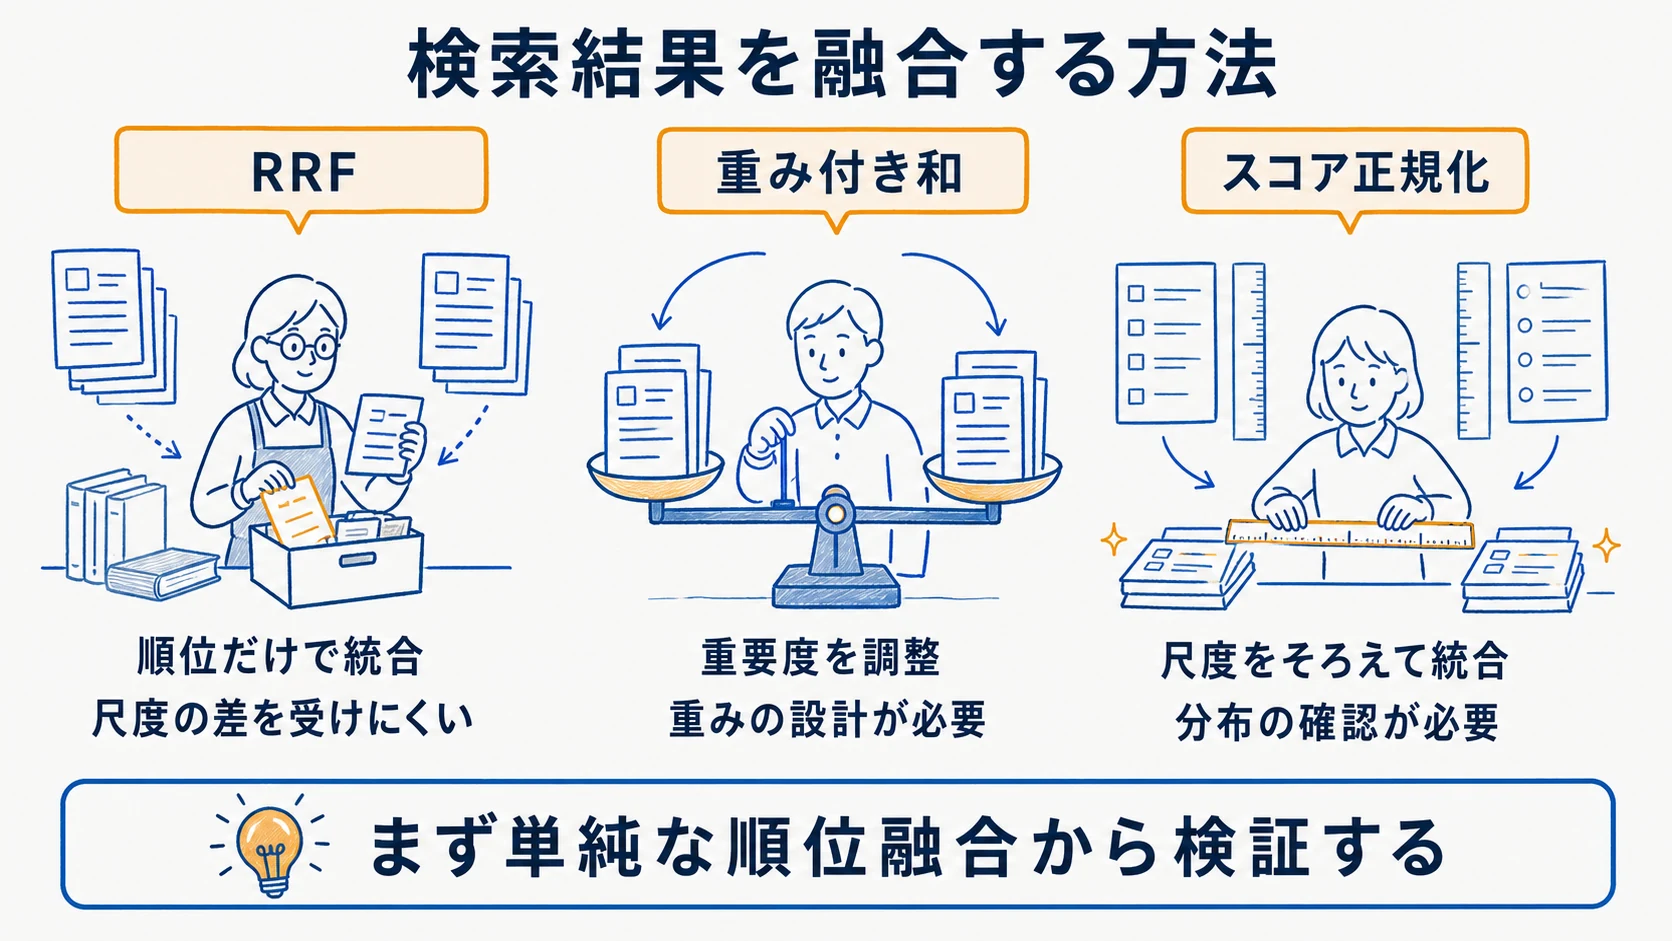
RRFは、各検索結果における文書dの順位rを使い、RRF(d)=Σ1/(k+r)という形で統合値を作ります。各一覧で上位にある文書ほど値が大きく、複数一覧に現れる文書は加算されます。BM25の検索スコアとベクトル類似度を直接比べないため、尺度の正規化が不要です(出典: Cormack, Clarke & Büttcher, SIGIR 2009)。
定数kを小さくすると最上位同士の差を強く反映し、大きくすると順位差をなだらかに扱います。万能な固定値はないため、検索方式ごとの候補数と併せ、正解文書が届く範囲、不要候補、応答時間を評価します。式が単純でも、評価なしにkを決めれば自社の質問分布とずれる可能性があります。
融合方式3種の比較と選び方(RRF/加重和/スコア正規化)
RRFは順位だけを使い、加重和は各方式のスコアへ重要度を掛け、スコア正規化融合は異なる尺度をそろえてから統合します。後の2方式は検索スコアの大きさを利用できますが、分布の変化や外れ値を含めて調整する項目が増えます(出所: ai-feed編集部作成)。
| 融合方式 | 正規化 | 主な調整項目 | 長所 | 短所 |
|---|---|---|---|---|
| RRF | 不要 | 定数k、候補数 | 異なる尺度を順位で統合 | 元スコアの差を捨てる |
| 加重和 | 尺度がそろわなければ必要 | 各検索の重み | 重要度を直接反映 | 重みと尺度が結果を左右 |
| スコア正規化融合 | 必要 | 正規化法、重み、候補数 | 元スコアを比較可能にする | 分布変化と外れ値に注意 |
最初の比較ではRRFを基準にしやすいものの、それが最適とは限りません。評価セットが安定し、特定方式を強める業務根拠があるなら加重和も候補です。スコア分布を監視できるなら正規化融合を試し、方式ごとに同じ評価指標と応答条件で比べます。
自社にハイブリッド検索は必要か(判定チェックリスト)
純ベクトル検索で足りるケース
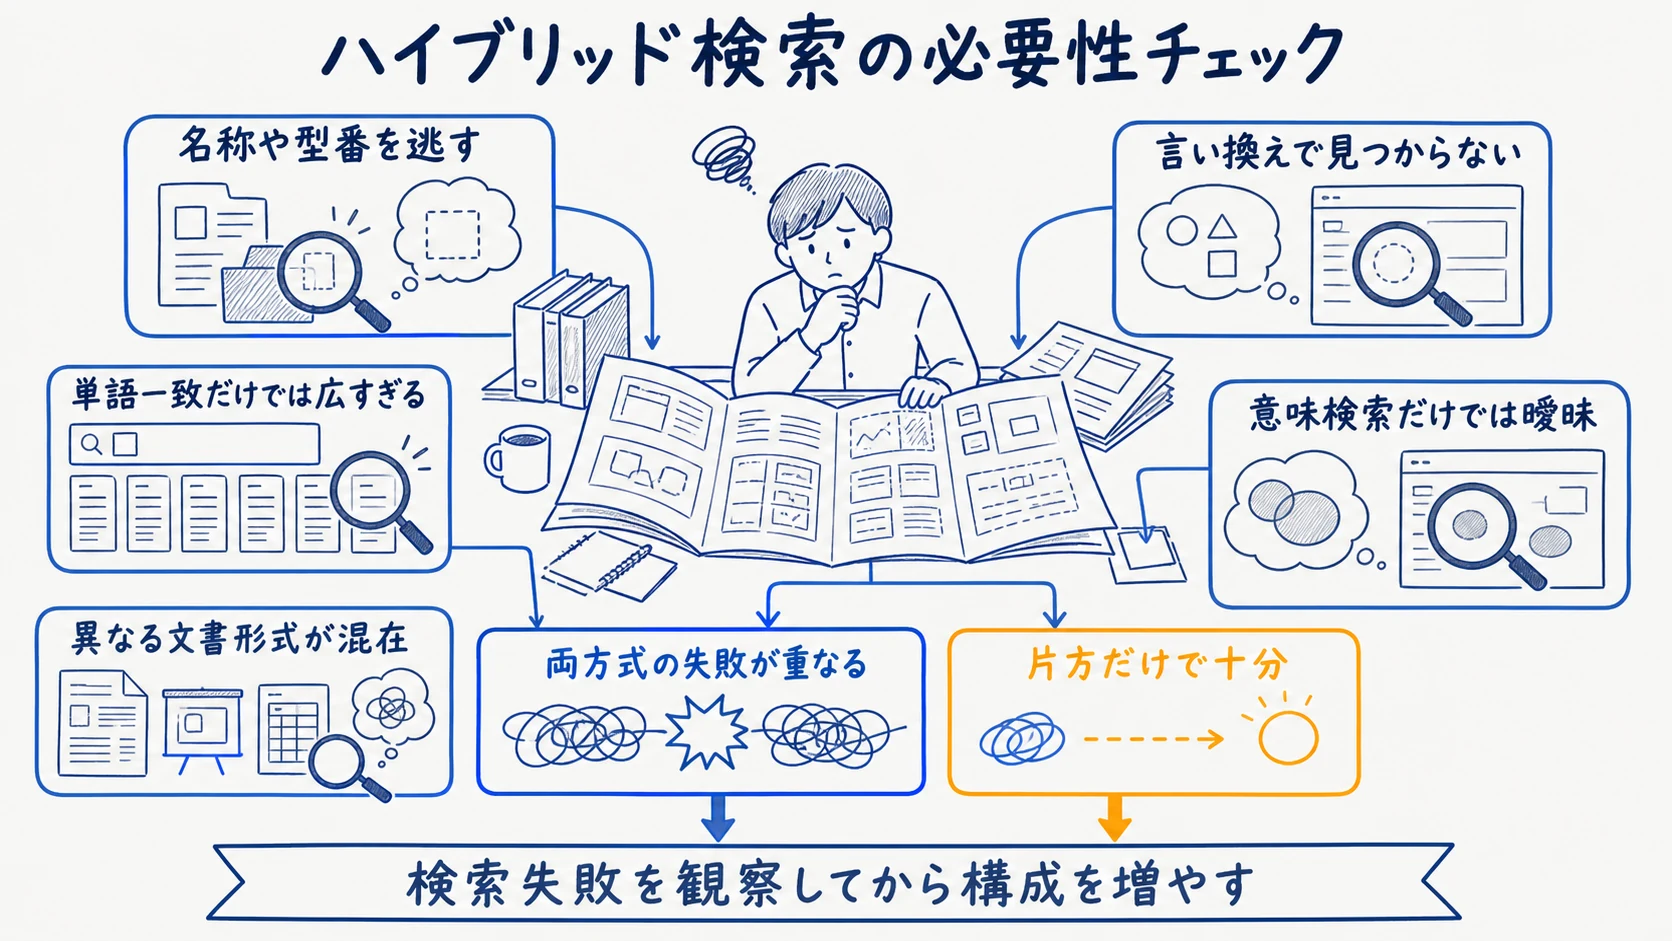
質問が自然文中心で、文書に固有名詞や型番が少なく、現行のベクトル検索で正解文書が安定して上位へ入るなら、純ベクトル検索を維持できます。文書量が小さく、利用部門や質問型が限定され、運用担当者も少ない場合は、単一索引の簡潔さが障害調査や更新確認を容易にします。
回答ミスがあるからといって、すぐ検索方式を増やす必要はありません。正解箇所が長いチャンクの中へ埋もれている、メタデータ絞り込みが欠ける、文書が古い、生成段階で根拠を無視している場合は別レイヤーの問題です。まずチャンク分割の設計を含めて切り分けます。
ハイブリッドが必要になる兆候チェックリスト
次の項目は導入可否を点数化するものではなく、検索ログから確認する兆候です。該当数で自動決定せず、同じ質問セットでBM25、ベクトル、融合後を比較します(出所: ai-feed編集部作成)。
- 社内固有名詞、型番、条項名、エラーコードをベクトル検索が逃す
- 言い換えや略称をBM25だけでは拾えない
- 完全一致だけでは同じ語を含む不要文書が多い
- 一つの質問に識別子と意味的な説明が混在する
- 両方式の失敗が異なり、融合すると正解候補が戻る
- 検索ログと正解文書を継続的に評価できる
最後の条件は特に重要です。評価できなければ、改善したように見えても不要候補、待ち時間、更新不整合の増加を検知できません。RAG評価の設計で、質問、正解文書、検索順位、回答根拠を同じ単位で記録します。
導入の代償と見送ってよいケース(中立フレーム)
2インデックス運用・レイテンシ増・kチューニングの負担
2インデックス運用では、文書の追加・更新・削除をキーワード索引とベクトル索引へ反映し、片方だけ古い状態を検知する必要があります。分割単位、文書ID、アクセス権、メタデータが一致しなければ、融合後に重複、欠落、権限外候補が混ざります。再構築と障害復旧も両方について手順化します。
レイテンシは検索2系統、融合、必要なら再順位付けを通るため増える可能性があります。並列化しても遅い側の完了、候補数、タイムアウトが応答を左右します。kだけでなく各検索の候補数、重み、重複除去を調整し、品質、応答時間、計算資源、運用工数を同じ評価表へ残します。
ハイブリッド検索を見送ってよい条件
単一方式で正解文書が十分に届き、検索失敗がチャンク、文書鮮度、権限、生成指示に集中するなら、ハイブリッド化を見送れます。文書更新の同期を担う人がいない、評価セットがない、厳しい応答時間を守れない場合も、先に運用基盤を整える方が再現性を保てます。
見送る判断は永久決定ではありません。固有名詞を含む質問が増えた、問い合わせ範囲が広がった、検索ログで方式ごとの取りこぼしが分かれた時点で再評価します。反対に、ハイブリッド導入後も品質差が小さいなら単一方式へ戻し、構成と障害点を減らします。
RAG検索品質改善レイヤー地図(独自図・関連記事マップ)
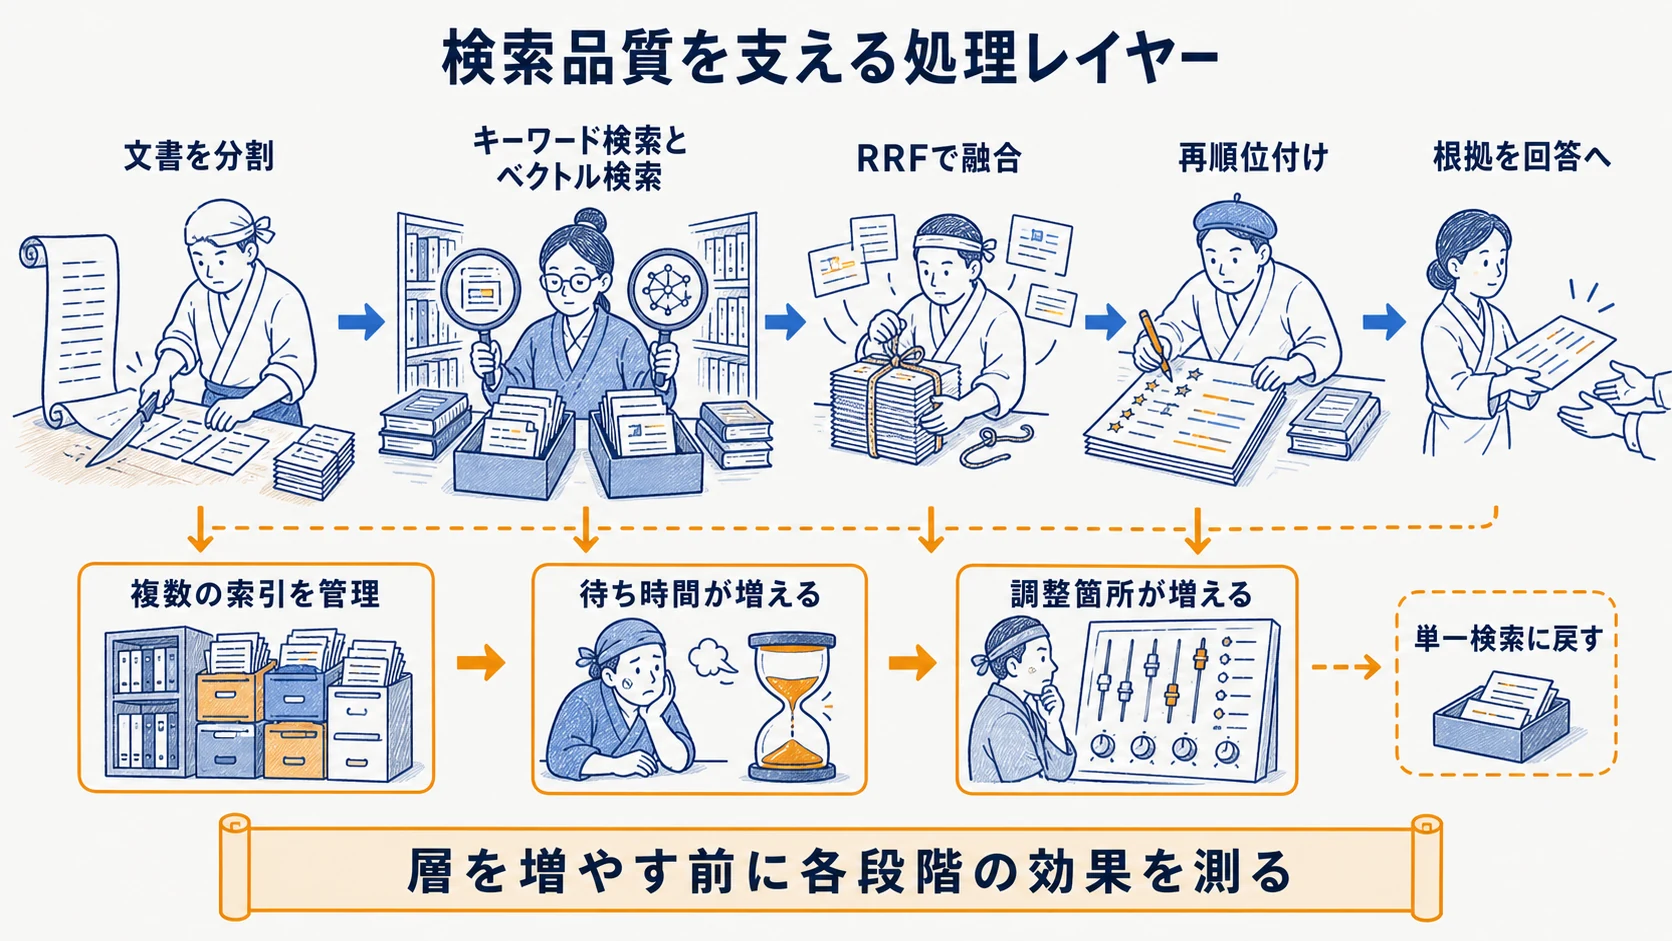
チャンク分割→ハイブリッド融合→リランカーの位置づけと各レイヤーの深掘り
検索品質は、文書を適切な単位へ分ける「チャンク」、BM25とベクトルで候補を集める「検索」、順位やスコアをまとめる「融合」、候補を質問との関連度で見直す「リランカー」、根拠を使って答える「生成」の順に観察します。ハイブリッド検索は検索と融合の層であり、チャンクや生成の問題を置き換えません(出所: ai-feed編集部作成)。
| レイヤー | 主な役割 | 代表的な失敗 | 確認する記録 |
|---|---|---|---|
| チャンク | 文書を検索単位へ分割 | 根拠の分断・情報過多 | 分割位置、重なり、見出し |
| 検索 | 複数方式で候補を取得 | 固有語・言い換えの漏れ | 方式別順位、候補数 |
| 融合 | 候補一覧を統合 | 重複・順位偏り | k、重み、統合順位 |
| リランカー | 候補を再評価 | 正解候補の降格 | 入力候補、再評価後順位 |
| 生成 | 根拠から回答 | 根拠無視・過剰補完 | 引用箇所、回答、判定 |
各層を一度に変更すると、改善理由を特定できません。固定した評価セットで一層ずつ比べ、正解候補が失われた地点を調べます。検索が正しくても生成が根拠外を補う場合は業務でのAIハルシネーション対策を併用し、検索指標と回答の事実性を分けて管理します。
まとめ
ハイブリッド検索RAGは、BM25の単語一致とベクトル検索の意味的類似を組み合わせ、RRFなどで候補を融合する手法です。固有名詞・型番と自然文の言い換えが同じ文書群に混在し、単一方式の取りこぼしが異なる場合に検討価値があります。
方式選択では、3方式を同じ質問セットで比較し、正解文書の順位、不要候補、応答時間を測ります。RRFは順位だけで統合でき、加重和とスコア正規化には別の調整余地がありますが、どれにも万能な勝者はありません。検索ログと業務要件に合う方式を選びます。
導入すると2インデックスの同期、レイテンシ、候補数・k・重みの調整が増えます。純ベクトルで足りる場合や評価基盤がない場合は見送ってよく、チャンク、融合、リランカー、生成を一層ずつ検証することが、品質向上と運用負担を両立する近道です。
よくある質問
- Q. ハイブリッド検索とは何ですか?
- キーワード検索(BM25)とベクトル検索を同時に実行し、候補の順位をRRFなどで融合する検索方式です。完全一致と意味的な近さという異なる得意領域を組み合わせ、検索漏れを減らします。
- Q. BM25とベクトル検索の違いは?
- BM25は単語の一致を基に順位付けするため固有名詞・型番に強く、ベクトル検索は意味の近さを基にするため言い換え・同義表現に強い方式です。どちらも文書と質問の性質によって取りこぼしが生じます。
- Q. RRF(Reciprocal Rank Fusion)とは?
- 複数の検索結果について、各文書の順位の逆数に基づく値を足し合わせ、統合順位を作る融合手法です。元の検索スコアを同じ尺度へ正規化せずに使える一方、定数kと候補数は評価データで検証します。
- Q. ハイブリッド検索は必ず必要ですか?
- 必須ではありません。固有名詞・型番・エラーコードが少なく、意味の近い文書を探す質問が中心で、純ベクトル検索の評価が十分なら単一方式を維持できます。
- Q. ハイブリッド検索のデメリットは?
- キーワード用とベクトル用の2つのインデックスを同期する負担、並列検索と融合によるレイテンシ増、候補数・定数k・重みの調整が増える点です。品質向上が運用負担を上回るかを測ります。
- Q. ハイブリッド検索とリランカーはどう違いますか?
- ハイブリッド検索は複数方式で集めた候補を一つに融合する段階です。リランカーは融合後の候補を質問との関連度で再評価して並べ替える別の段階で、必要に応じて併用できます。